修订说明(2026-11):修正位数组索引示例,并补充计数布隆过滤器的删除前提。
布隆过滤器介绍
布隆过滤器适合在大量元素中做低内存开销的成员查询,也常用于缓存穿透防护。但它不能独自证明某个元素一定存在。
什么是布隆过滤器
布隆过滤器(Bloom Filter)由 Burton H. Bloom 在 1970 年提出。它使用位数组和多个哈希位置:插入时把对应位置设为 1;查询时检查这些位置是否都为 1。
它的优点是节省空间,查询只需检查少量位置;代价是可能出现假阳性,而且普通布隆过滤器不能直接删除元素。实际误判率取决于位数组大小、哈希函数数量和插入元素数量,不能笼统说它总比其他方案快。
下图就是一个经过了2次哈希函数得到的布隆过滤器,根据下图我们很容易看到:假如Redis这个字符串根本不存在,但是Redis经过
2次哈希函数之后得到的两个位置已经是1了(一个是wolf通过f2得到,一个是Nosql通过f1
得到,这就是发生了哈希碰撞,也是布隆过滤器可能存在误判的原因)。
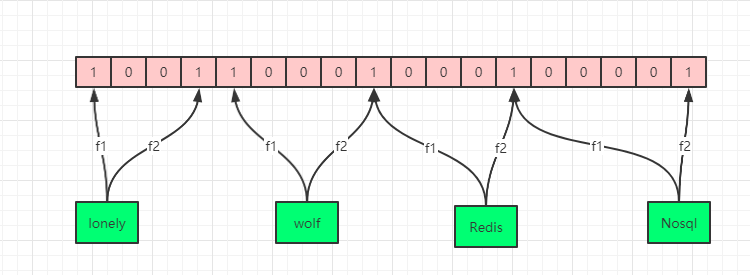
所以通过上面的现象,我们从布隆过滤器的角度可以得出布隆过滤器主要有2大特点:
- 如果布隆过滤器判断一个元素存在,那么这个元素 可能存在。
- 如果布隆过滤器判断一个元素不存在,在 插入与查询使用相同哈希规则、位未被错误清除的前提下,这个元素一定不在已插入的集合里。
bloom过滤器简单demo
下面只演示进程内的基本操作。三个 salt 仅用于说明多个哈希位置,不代表生产环境的哈希方案。HashCode.Combine 的结果不保证跨进程或
.NET 版本稳定,因此这个示例不能直接持久化位数组,也不适合多个进程共用同一过滤器。
using System;
using System.Collections;

public sealed class MyBloomFilter
{
    private const int Size = 1 << 16; // 65536,2 的幂
    private readonly BitArray _bits = new(Size);

    private static int Index(string value, int salt)
        => (int)((uint)HashCode.Combine(value, salt) & (Size - 1));

    public void Add(string value)
    {
        for (var salt = 0; salt < 3; salt++)
            _bits[Index(value, salt)] = true;
    }

    public bool MightContain(string value)
    {
        for (var salt = 0; salt < 3; salt++)
            if (!_bits[Index(value, salt)]) return false;
        return true;
    }
}
bloom过滤器的删除
普通布隆过滤器只知道某一位是否为 1,不知道有多少元素把它设为 1,因此不能直接清零来删除。计数布隆过滤器把位替换为计数器:插入时给各位置加一;查询时检查是否都大于 0; 确认元素确实插入过之后,才可在删除时给对应位置减一。
“可能存在”不足以作为删除依据,因为假阳性的元素根本没有插入,直接减计数可能让其他真实元素查询时出现假阴性。还要处理重复插入、同一元素多个哈希位置重合、计数器上溢和下溢。
byte 的最大值是 255,不代表能无条件承受 254 次冲突;旧示例中的 Math.Abs(int.MinValue) 还会溢出,hash & 65535
也会产生超出长度为 65535 的数组索引。
参考资料:
读到这里,感谢你。